Veri Kurtarma
Synology ve QNAP NAS Cihazlarında RAID Arızaları Nasıl Yönetilir?
NAS cihazlarında RAID bozulması (Degraded status) veya RAID çökmesi (Crashed status), depolama havuzundaki bir veya daha fazla disğin işletim sistemi çekirdeği (Linux Kernel) tarafından diziden çıkarılması (drop) anlamına gelir. Synology DSM ve QNAP QTS sistemlerinde bu durum yaşandığında, arka planda çalışan mdadm veya LVM katmanı verilerin parite bütünlüğünü kaybeder veya metaveri (metadata) yazım hataları nedeniyle diziyi salt okunur (read-only) moda alır ya da tamamen unmount eder. Sistem yöneticilerinin bu aşamada yaptığı en büyük müdahale hataları; cihazı panikle kapatıp açmak, arızalı diski tespit etmeden rastgele yeni disk takarak Rebuild başlatmak, SSH terminalinden bilmeden mdadm --force veya btrfs check --repair komutları çalıştırmak ve disk sıralamasını karıştırmaktır.
Synology NAS RAID Arızası ve QNAP RAID Çökmesi Belirtileri
Synology DiskStation Manager (DSM) ve QNAP QTS/QuTS hero işletim sistemleri, depolama mimarisinde oluşmaya başlayan fiziksel ve mantıksal hataları farklı katmanlarda raporlar. Donanımsal ve yazılımsal düzeydeki bu uyarı işaretlerini doğru okumak, felaket senaryolarının önüne geçer.
Synology DSM Arıza Sinyalleri ve Disk Unmounted Durumu
Synology sistemlerinde RAID yapısı bozulduğunda ilk tepki donanım sürücülerinden ve DSM Storage Manager arayüzünden gelir. Sistem, veri bütünlüğünü korumak için doğrudan koruma moduna geçer.
| Başlık | Açıklama |
|---|---|
| STATUS ve Disk LED Uyarısı | Cihaz kasasında yer alan STATUS göstergesi turuncu veya kırmızı renkte yanıp söner. Disk yuvalarındaki (Drive Bays) LED'ler ise yeşilden kırmıza döner veya tamamen söner. |
| Storage Manager Degraded / Crashed Modu | Arayüzde Depolama Havuzu (Storage Pool) durumu "Bozulmuş" (Degraded) veya "Çökmüş" (Crashed) olarak işaretlenir. Single-volume yapı kurulduysa volüm doğrudan erişime kapanır. |
| Btrfs Read-Only Lock | DSM, Btrfs dosya sisteminde metadata ağacı bozulduğunda veri kaybını durdurmak için volümü salt okunur moda kilitler. Bu durumda yeni veri yazılamaz ve mevcut paylaşımlar kopabilir. |
| Volume Unmounted ve I/O Hataları | Linux dmesg kayıtlarında I/O error, dev sda, sector... şeklinde girdiler oluşur. Sistem ilgili bloğu okuyamadığı için mount noktasını sistemden ayırır (unmount). |
QNAP QTS ve QuTS hero Depolama Havuzu Arızaları
QNAP depolama sistemleri, LVM (Logical Volume Manager) ve QuTS hero modellerinde ZFS dosya mimarisi kullandığından arıza belirtileri Synology'ye göre farklı teknik derinlikler gösterir.
| Başlık | Açıklama |
|---|---|
| Storage & Snapshots Uyarısı | QTS panelinde depolama havuzu kilitlenir. Volüm durumu "Inaccessible" (Erişilemez) veya "Error" durumuna geçer. |
| ZFS Pool Degraded / Faulted (QuTS hero) | ZFS mimarisinde SPA (Storage Pool Allocator) seviyesinde bir disk kaybı yaşandığında pool DEGRADED veya FAULTED moduna geçer. ZIL (ZFS Intent Log) veya L2ARC SSD önbellek disklerindeki arızalar da tüm havuzu dondurabilir. |
| Kasa Sesli İkazları | QNAP anakartı üzerindeki buzzer mekanizması, dizi bütünlüğü bozulduğunda kesintisiz veya periyodik sesli ikaz verir. |
| Thick/Thin Provisioning Kilitlenmeleri | LVM tabanlı Thin Volume alanlarında metadata alanının dolması veya bozulması sonucu volümler aniden offline duruma düşer. |
NAS Diski Görmüyor Sorunu: Donanımsal ve Mantıksal Nedenler
Bir NAS sunucusunun diski hiç tanımaması veya slot seviyesinde "No Disk Detected" hatası vermesi iki ana nedene dayanır: fiziksel donanım arızaları ve mantıksal SATA/SAS protokol hataları.
- PCB Kartı ve Motor Yanmaları: Voltaj dalgalanmaları nedeniyle HDD kartındaki TVS diyotlarının yanması veya motor kilitlenmesi (Spindle Seizure) sonucu disk spin-up olamaz.
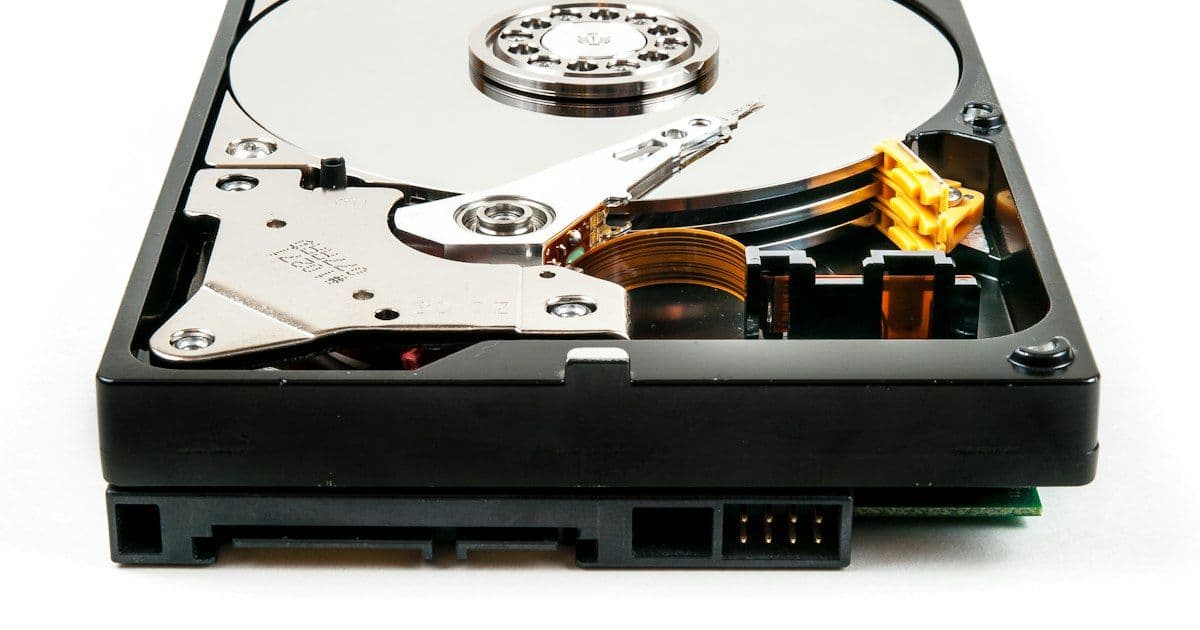
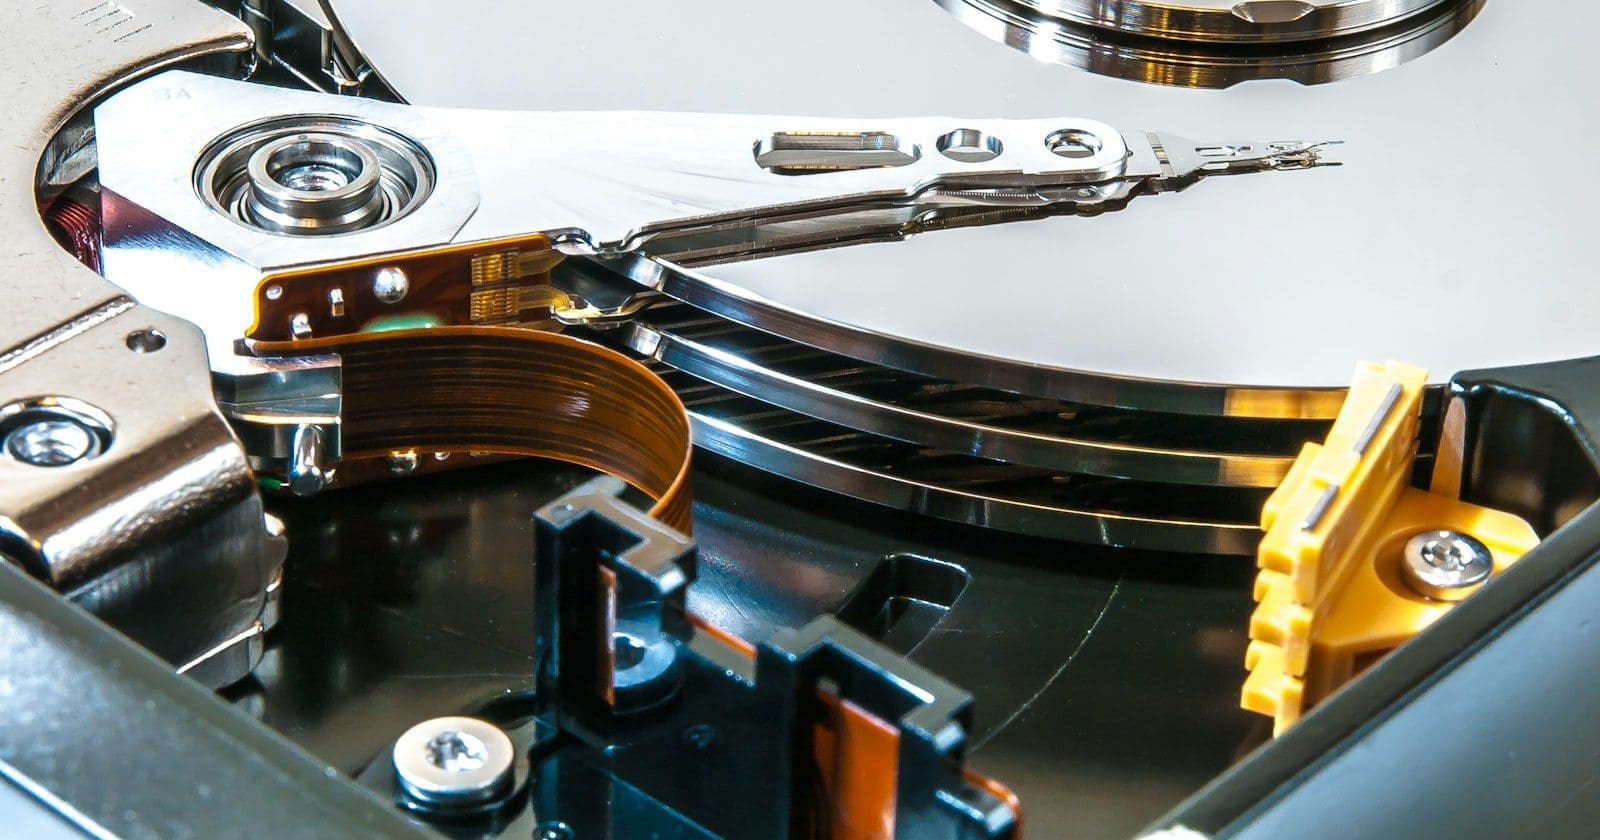
- Okuma/Yazma Kafası Arızaları (Head Crash): Disk kafasının plaka (platter) yüzeyine çarpması sonucu mikro çizikler oluşur. Disk, BIOS ve NAS backplane denetleyicisi tarafından ID bilgisi okunamadığı için algılanmaz.
- NAS Backplane ve SATA Controller Çökmesi: Disklerin takıldığı arka panel (backplane) üzerindeki kondansatörlerin kuruması veya PCIe SATA/SAS denetleyicisinin aşırı ısınarak hatayı tetiklemesi.
- S.M.A.R.T. Tablosunun Aşırı Dolması ve Firmware Kilitlenmesi: Disk üzerindeki Servis Alanı (Service Area - SA) bölgesinde yer alan translator veya P-List/G-List tablolarının dolması sonucu sürücü kendisini meşgul (BUSY) modda kilitler.
RAID 5 Rebuild Hatası ve RAID 6 Çökme Riskleri
RAID mimarileri veri güvenliği sağlamak amacıyla tasarlanmış olsa da, arıza anında yapılan hatalı işlemler süreci geri dönülmez veri kayıplarına sürükler. Özellikle RAID 5 ve RAID 6 dizilerinde Rebuild süreci en kritik aşamadır.
Rebuild Sırasında İkinci Disk Arızası ve Bad Sector (URE) Mantığı
RAID 5 mimarisi $N$ adet diskten oluşur ve toplam kapasite $(N - 1) \times S$ formülüyle hesaplanır. Yapı, tam olarak 1 disk toleransına sahiptir.
| Başlık | Açıklama |
|---|---|
| Aşırı I/O Yükü ve Yüksek Sıcaklık | Bozulan bir disğin yerine yenisi takılıp Rebuild başlatıldığında, sistem kalan tüm disklerin her bir sektörünü okumak zorundadır. Saatlerce süren bu %100 I/O okuma stresi, halihazırda yıpranmış olan sağlam diskleri aşırı ısıtır. |
| Unrecoverable Read Error (URE) Riski | Standart SATA/NAS disklerinin URE oranı genelde $10^{14}$ bit okumada 1 hatadır. Yüksek kapasiteli (12TB, 16TB, 20TB) disk gruplarında Rebuild yapılırken okunacak terabaytlarca veri, matematiksel olarak en az 1 okuma hatası çıkma olasılığını %90'ın üzerine taşır. |
| Aynı Üretim Serisi (Lot) Riski | NAS cihazındaki diskler genelde aynı tarihte ve aynı seride satın alınır. Bir disk ömrünü tamamlayıp bozulduğunda, yanındaki disğin de aynı çalışma saatinde olması ve aynı anda arızalanması çok sık görülen bir durumdur. |
| İkinci Disk Düşmesi | Rebuild esnasında sağlam kalan disklerden biri dahi okuma hatası verir veya diziden düşerse, Linux mdadm süreci derhal iptal eder ve RAID 5 yapısı kilitlenerek çöker (Crashed). |
Neden Bilinçsiz Rebuild İşlemine Başlanmamalı?
RAID 5 rebuild hatası, kurumsal ortamlarda veri kaybının bir numaralı sebebidir. Disk arızası tespit edildiğinde S.M.A.R.T. analizleri yapılmadan ve imaj alınmadan Rebuild başlatılmamalıdır.
| Başlık | Açıklama |
|---|---|
| Parite Verisinin Üzerine Yanlış Yazım | Rebuild işlemi, mevcut parite bloklarını kullanarak yeni diske veri yazar. Eğer sağlam disklerden birinde sessiz veri bozulması (Silent Data Corruption) varsa, parite yanlış hesaplanır ve sağlam verilerin üzerine çöp veri yazılır. |
| Mantar Etkisi Yaratan Disk İflasları | Yüksek yük altında çalışan disklerin okuma/yazma kafaları mikron düzeyinde yıpranır. Rebuild esnasında kafa plakaya temas ederek fiziksel yıkım başlatabilir. |
| Zaman Kaybı ve Risk Artışı | 8 diskli bir RAID 5 dizisinde Rebuild süresi günler sürebilir. Bu süre boyunca sistem tamamen korumasızdır ve ikinci bir arızada veri havuzu tamamen yok olur. |
Synology SHR (Hybrid RAID) ve QNAP Storage Pool Yapılarındaki İnce Hatalar
Klasik RAID yapılarından farklı olarak Synology SHR (Synology Hybrid RAID) ve QNAP Storage Pool sistemleri, arka planda karmaşık bir LVM ve mdadm katmanı barındırır.
- Farklı Boyuttaki Disklerin Dilimlenmesi (Slicing): SHR, farklı boyutlardaki diskleri alt parçalara (sub-arrays) böler ve her parçayı kendi içinde RAID 1 veya RAID 5 yapar. Rebuild esnasında birden fazla sub-array aynı anda senkronize edilmeye çalışılır, bu da diskler üzerindeki I/O yükünü katlar.
| Başlık | Açıklama |
|---|---|
| QNAP LVM Thin Provisioning Karmaşası | QNAP sistemlerinde depolama havuzları sabit RAID dizisi üzerinde LVM katmanı işletir. Rebuild sırasında LVM metadata alanında oluşacak tek bir sektör hatası, havuz içindeki tüm sanal volümlerin ve iSCSI LUN'ların haritasını bozar. |
| Qtier Otomatik Katmanlama Tehlikesi | QNAP Qtier aktifse, veriler SSD ve HDD katmanları arasında sürekli taşınır. RAID arızası anında Qtier haritası bozulursa, verinin hangi katmanda olduğunu tespit etmek karmaşık hex analizleri gerektirir. |
NAS Degraded Mode Çözümü ve Acil Durum Müdahale Rehberi
Bir NAS cihazı "Degraded" veya "Crashed" uyarısı verdiğinde, sistem yöneticisinin ilk yapacağı müdahaleler verilerin tamamen kurtarılabilmesini veya kalıcı olarak kaybedilmesini belirler.
Sistem Yöneticilerinin Kriz Anında Yapması Gereken Adımlar
Soğukkanlı davranmak ve adımları sıralı bir şekilde uygulamak sistem mimarisini korur.
| Başlık | Açıklama |
|---|---|
| I/O İşlemlerini Derhal Durdurun | NAS üzerindeki paylaşımları (SMB, NFS, iSCSI) kapatın. Ağ kablosunu çekerek kullanıcıların veya arka plan servislerinin cihaza veri yazmasını engelleyin. |
| Sistemi Kontrollü Kapatın | Web arayüzü yanıt veriyorsa sistemi yazılımsal olarak kapatın. Sistem kilitlendiyse ve yanıt vermiyorsa, güç tuşuna basılı tutmak yerine tek bir kısa basışla kapatmayı deneyin; olmuyorsa fiziki gücü kesin. |
- Disk Sıralamasını ve Yuvaları İşaretleyin: Diskleri cihazdan çıkarmadan önce kalıcı bir kalemle veya etiketle hangi disğin hangi yuvadan (Bay 1, Bay 2, Bay 3...) çıktığını eksiksiz kaydedin.
- Arayüz Loglarını ve S.M.A.R.T. Verilerini Kaydedin: Imkan varsa kapatmadan önce DSM veya QTS üzerindeki sistem loglarını,
mdadmdurum raporunu ve disklerin S.M.A.R.T. değerlerini dışarı aktarın.
Asla Yapılmaması Gereken Ölümcül Hatalar
Sahada yapılan bilinçsiz müdahaleler, profesyonel RAID veri kurtarma laboratuvarlarının işini zorlaştırır veya imkansız hale getirir.
UYARI : SSH üzerinden yetkisiz komut çalıştırmak RAID parametrelerini tamamen siler!
- Rastgele Disk Değişimi ve Rebuild Zorlaması: Bozuk olan disğin hangisi olduğundan %100 emin olmadan ve diğer disklerin imajını almadan yeni disk takıp Rebuild başlatmayın.
| Başlık | Açıklama |
|---|---|
| SSH Üzerinden Bilinçsiz | **mdadm** Komutları Çalıştırmak: mdadm --create --force veya mdadm --assemble --force komutlarını alt parametreleri bilmeden çalıştırmak, diskler üzerindeki RAID metadata (superblock) alanlarını sıfırlar. |
| Dosya Sistemi Onarım Araçlarını ( | **e2fsck**, **btrfs check**) Çalıştırmak: Eksik veya sırası bozulmuş bir RAID dizisi üzerinde e2fsck -y veya btrfs check --repair çalıştırmak, dosya sistemi yapısını tamamen yıkar ve düğüm (inode) tablolarını siler. |
| Disklerin Yerini Karıştırıp Cihazı Açmak | Disklerin sırasını karıştırıp cihazı açtığınızda, Linux RAID denetleyicisi parite bloklarını yanlış eşleştirebilir ve süper bloğa hatalı dizi sırası yazabilir. |
- Çöken Disklere "Buzdolabı" veya "Tıklatma" Yöntemleri Uygulamak: İnternette yer alan amatör tavsiyelerle diskleri dondurmak veya vurmak, plakalar üzerinde telafisi mümkün olmayan fiziksel çizikler (Media Damage) oluşturur.
DrDisk Lab Laboratuvar Düzeyinde Synology QNAP Veri Kurtarma Süreci
DrDisk Lab, donanımsal veya mantıksal olarak çöken Synology, QNAP, Asustor ve custom Linux RAID depolama sistemlerine profesyonel RAID veri kurtarma standartlarında müdahale eder.
1. Donanımsal Hazırlık, Cleanroom Müdahalesi ve Çip Seviyesinde Analiz
Veri kurtarma süreci, disklerin fiziksel durumlarının incelenmesiyle başlar. Hasarlı diskler kesinlikle doğrudan okumaya zorlanmaz.
| Başlık | Açıklama |
|---|---|
| Cleanroom Class 100 Ortamı | Okuma/yazma kafası hasarlı, motoru kilitli veya plaka yüzeyinde toz riski bulunan diskler ISO 5 Class 100 Temiz Oda ortamında açılır. Kafa değişimi (Head Swap) özel donanım aparatları ile gerçekleştirilir. |
| PCB ve ROM / NVRAM Analizi | Yanmış veya mikro kod yapısı bozulmuş PCB kartları, donanımsal programlayıcılar ile analiz edilir. Adaptif ROM parametreleri yeni donanıma aktarılır. |
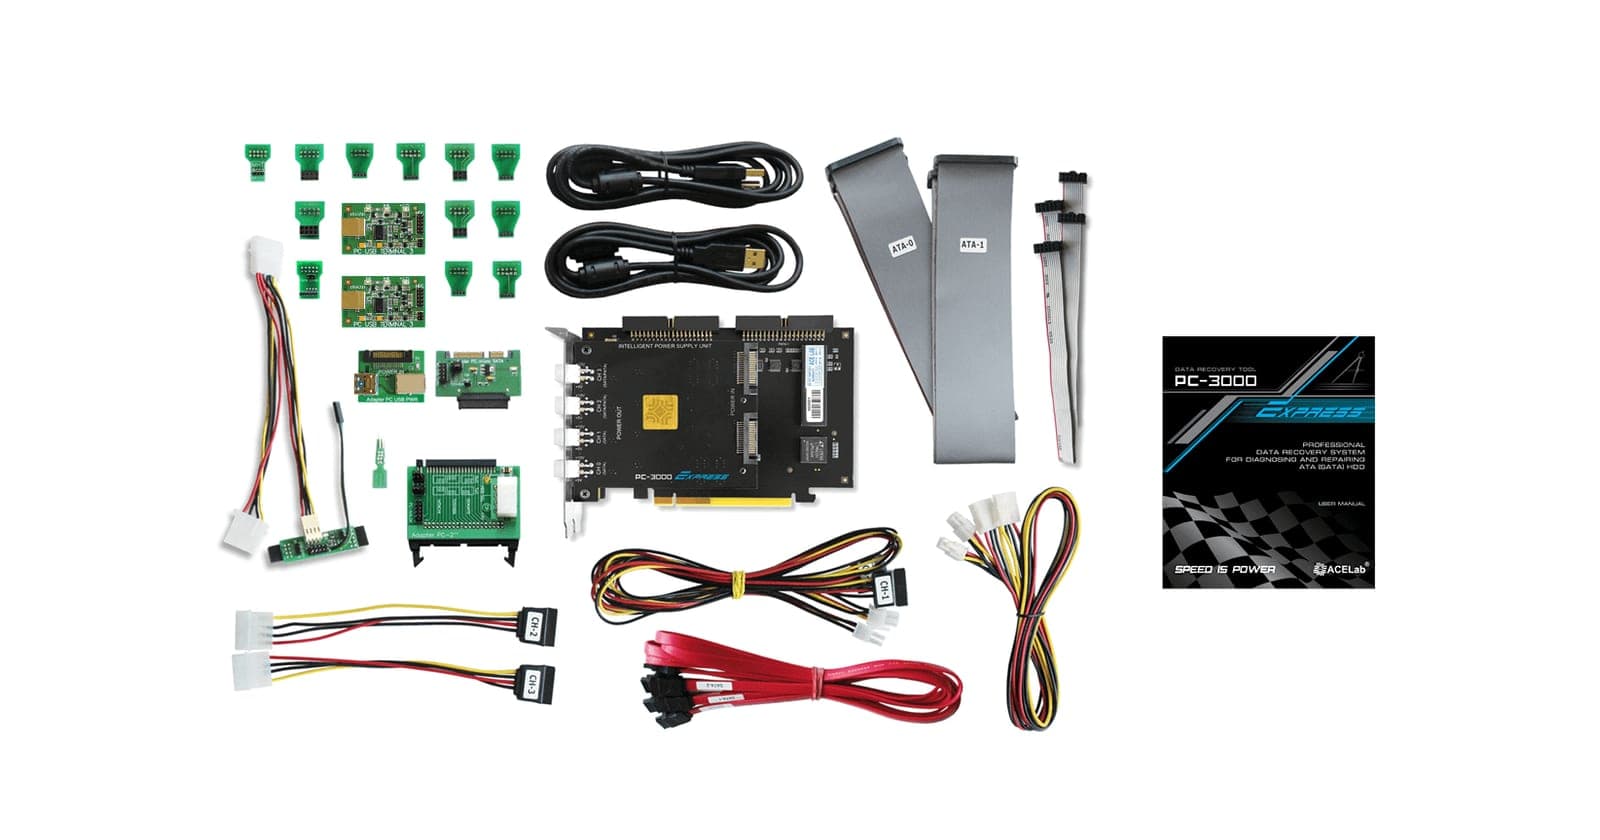
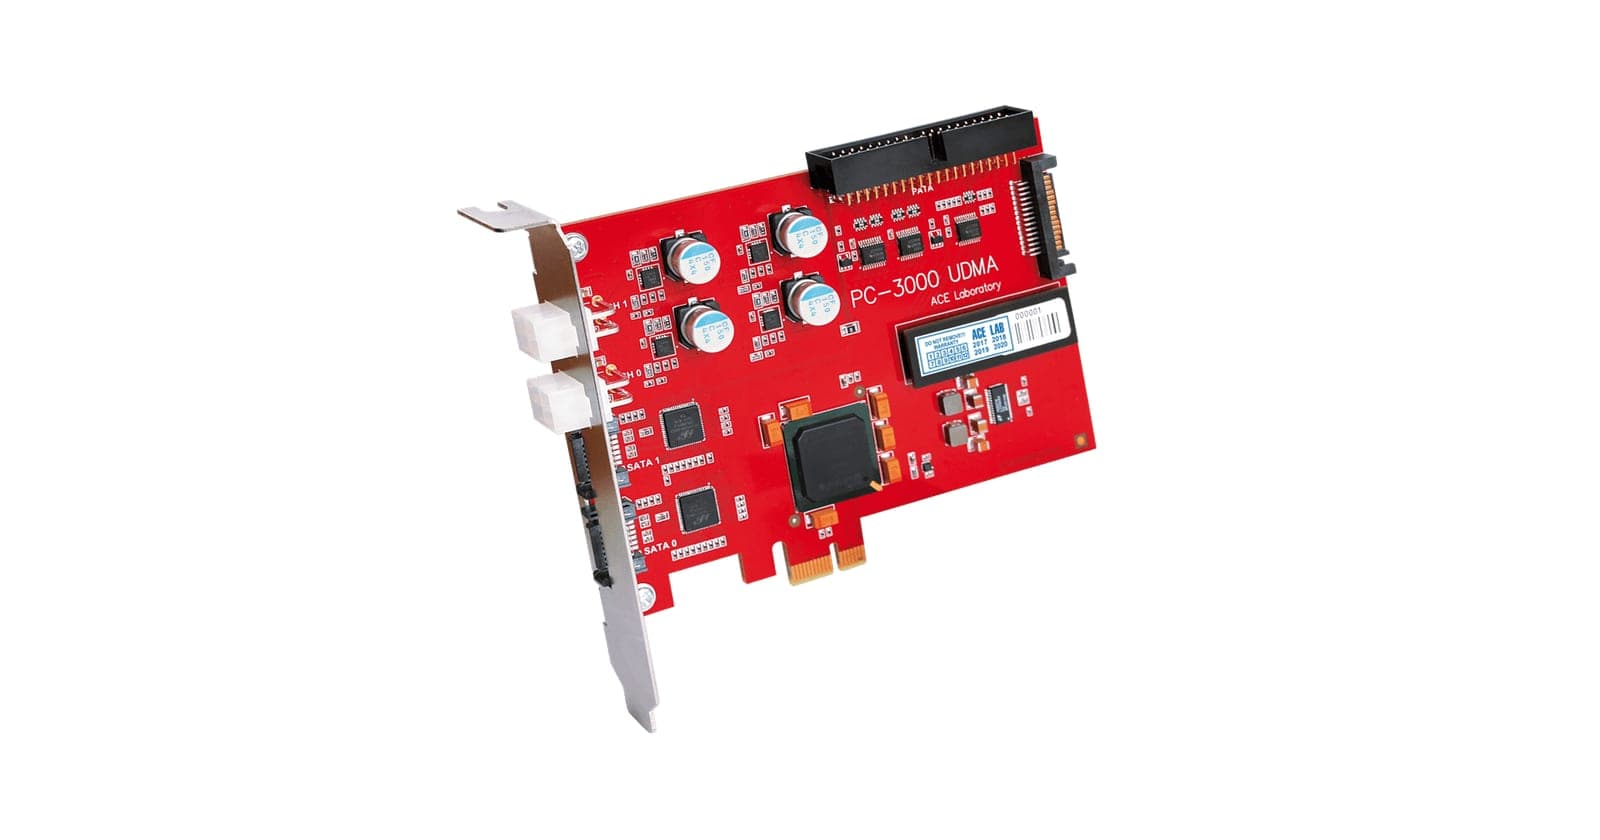
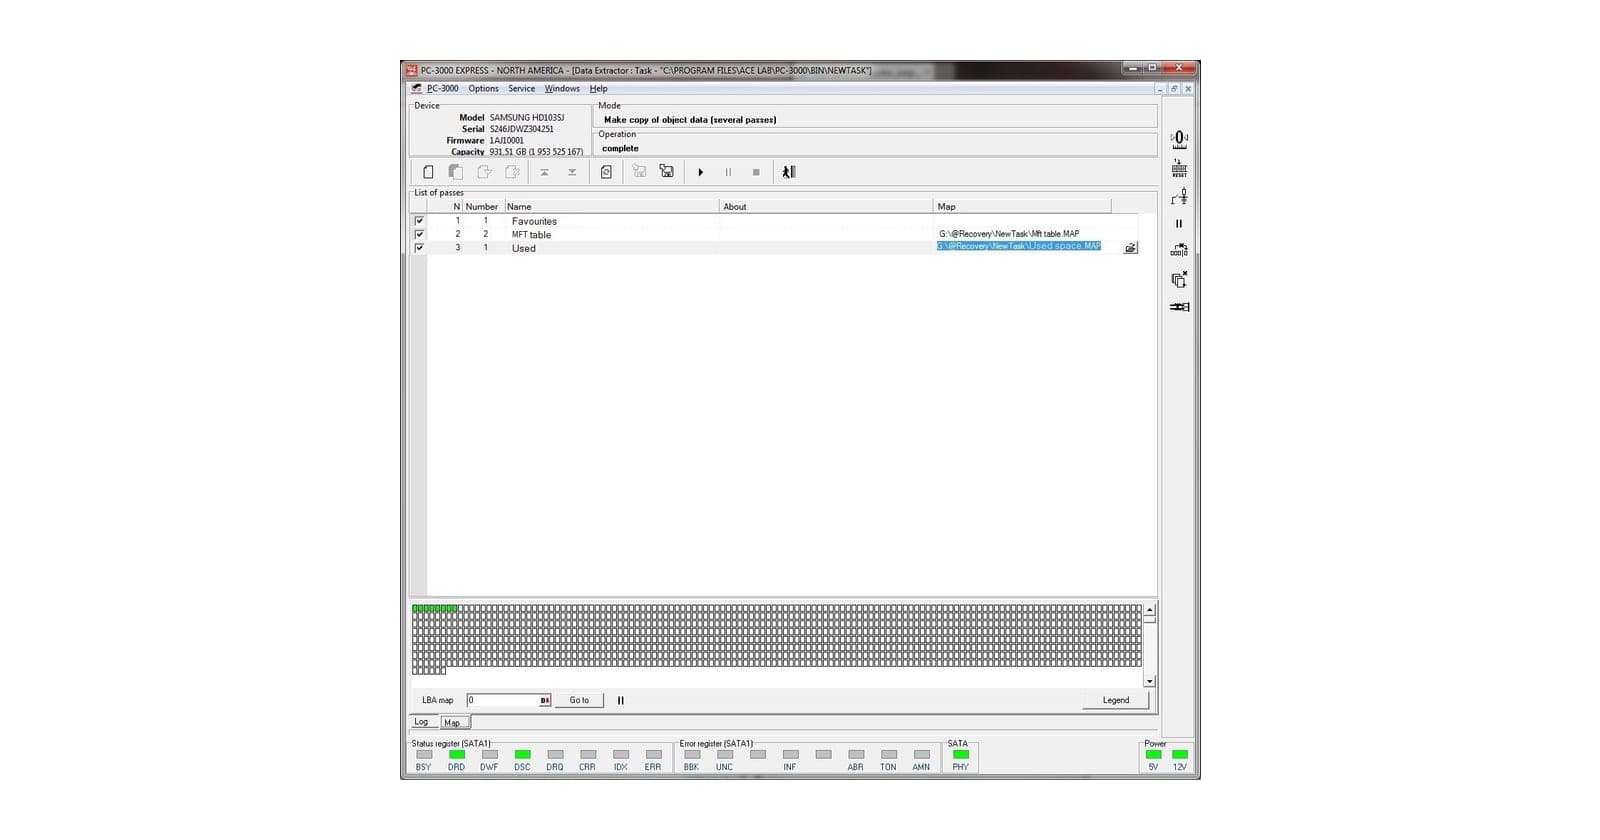
| Firmware Onarımı (PC-3000 SAS/Express) | Endüstri standardı PC-3000 donanımları kullanılarak disklerin Servis Alanı (Service Area - SA) modülleri, P-List/G-List hataları ve translator sorunları giderilir. |
2. PC-3000 ile Sektör Sektör Birebir İmaj (Sector-by-Sector Imaging)
Laboratuvarımızda orijinal müşteri diskleri üzerinde kesinlikle doğrudan analiz veya kurtarma işlemi yapılmaz.
- Ham İmaj (RAW Image) Oluşturma: Her bir disk, sektör sektör (LBA 0'dan son sektöre kadar) birebir donanımsal imaj cihazlarına kopyalanır.
- Zayıf Kafaların (Degraded Heads) Yönetimi: Okuma esnasında hata veren kafalar yazılımsal olarak kapatılır, öncelikle sağlıklı kafaların imajı tamamlanır. Daha sonra zayıf kafalar için okuma voltajı ve zaman aşımı (timeout) değerleri ayarlanarak maksimum sektör elde edilir.
- Bad Sector Haritalama: Okunamayan Bad Sector bölgeleri haritalandırılır ve parite rekonstrüksiyonu aşamasında matematilsel olarak hesaplanmak üzere işaretlenir.
3. Hex Seviyesinde Sanal RAID Rekonstrüksiyonu ve Superblock Onarımı
Disk imajları elde edildikten sonra, fiziksel NAS donanımına ve işletim sistemine ihtiyaç duyulmadan sanal ortamda dizi inşasına geçilir.
- Superblock ve RAID Metadata Analizi: Hex editörler ve özel yazılımlar aracılığıyla Linux Software RAID metadata blokları incelenir.
- Kritik RAID Parametrelerinin Tespiti:
- Stripe (Chunk) Size: Şerit boyutu (64KB, 128KB, 512KB vb.) hex seviyesinde doğrulanır.
- Parite Yönü ve Mimarisi: Left Asymmetrical, Left Synchronous, Right Asymmetrical veya Right Synchronous parite dizilimi tespit edilir.
- Disk Sıralaması (Disk Order): Diziye ait doğru disk sırası, dosya sistemi header'ları ve inode sürekliliği takip edilerek manuel olarak belirlenir.
- Offset Değeri: Volümün başladığı ilk sektör (Data Offset) hesaplanır.
- Sanal Dizi Oluşturma: Donanımdan bağımsız olarak oluşturulan sanal RAID kontrolcüsü üzerinde dizi ayağa kaldırılır. Biri eksik veya bozuk olan disklerin paritesi, kalan disklerin verileriyle matematiksel olarak XOR işlemine tabi tutularak tamamlanır.
4. Btrfs, ext4, ZFS Dosya Sistemlerinin Derinlemesine Yapılandırılması
Sanal RAID dizisi oluşturulduktan sonra, üzerindeki karmaşık dosya sistemleri ve mantıksal birimler çözümlenir.
| Başlık | Açıklama |
|---|---|
| Synology Btrfs ve LVM Çözümlemesi | DSM'in kullandığı LVM katmanı altındaki Btrfs Chunk Tree, Root Tree ve Inode Tree yapıları taranır. Btrfs metadata ağacındaki bozuk bloklar bypass edilerek dosyalar çıkarılır. |
| QNAP LVM ve Thin Pool Rekonstrüksiyonu | QNAP'ın kullandığı LVM2 metadata alanları ve pool mapping tabloları hex düzeyinde birleştirilir. Thin Provisioning alanındaki parçalanmış (fragmented) bloklar doğru adreslere eşlenir. |
| ZFS Storage Pool (QuTS hero) Kurtarma | ZFS MOS (Meta Object Set), Uberblock ve dnode ağaçları taranarak zpool yapısı sanal olarak monte edilir. |
- iSCSI LUN ve Sanallaştırma Dosyaları (VMDK/VHDX): Depolama alanında yer alan iSCSI target LUN yapıları, LUN header haritası çıkarılarak ham
.imgveya.vhdxbiçiminde sorunsuz olarak dışarı aktarılır. - Veri Bütünlüğü Testi: Kurtarılan verilerin MD5/SHA256 hash kontrolleri, veritabanı (SQL, Oracle) bütünlük testleri ve dosya açılış doğrulamaları yapılarak sistem yöneticisine teslim raporu hazırlanır.
Sıkça Sorulan Sorular
NAS cihazında RAID degraded uyarısı verince ilk ne yapılmalı?
NAS cihazınızda "Degraded" uyarısı gördüğünüzde ilk olarak sisteme yeni veri yazılmasını ve aktif I/O işlemlerini derhal durdurun. Eğer güncel ve doğrulanmış bir yedeklemeniz yoksa, kesinlikle bilmeden arızalı diski çekip yerine yeni disk takarak Rebuild işlemini başlatmayın. Cihazın güç durumunu kontrollü şekilde kapatın, tüm disklerin takılı olduğu yuva numaralarını (Bay 1, Bay 2...) silinmez bir etiketle işaretleyin ve disk imajları üzerinden işlem yapabilecek profesyonel bir RAID veri kurtarma laboratuvarı ile iletişime geçin.
QNAP veya Synology cihazına yeni disk takıp rebuild yapmak verileri siler mi?
Sağlıklı çalışan ve sadece tek bir disği arızalanmış standart bir RAID 1 veya RAID 5 dizisinde yeni disk takıp Rebuild başlatmak teorik olarak verileri silmez. Ancak pratikte, Rebuild işlemi kalan diğer diskleri %100 okuma yükü altına soktuğu için, aşınmış durumdaki diğer sağlam görünen disklerde Bad Sector çıkması veya ikincil bir disk arızasının yaşanması durumunda Rebuild işlemi yarıda kesilir. Bu durumda RAID dizisi "Crashed" moduna geçer, dosya sistemi tablosu bozulur ve tüm veriler erişilemez hale gelir.
Çöken RAID yapısından veri kurtarmak mümkün müdür?
Evet, birden fazla diski fiziksel veya mantıksal olarak arızalanmış, RAID metaverisi (superblock) silinmiş, formatlanmış veya LVM katmanı bozulmuş Synology ve QNAP cihazlarından veri kurtarmak mümkündür. DrDisk Lab laboratuvarında arızalı disklerin Cleanroom ortamında çip ve mekanik onarımları yapıldıktan sonra sektör bazlı imajları alınır; ardından parametreler hex düzeyinde hesaplanarak sanal RAID rekonstrüksiyonu gerçekleştirilir. Doğru müdahale edildiğinde ve disklerin üzeri ezilmediği (overwrite) sürece başarı oranı %95'in üzerindedir.
İlgili hizmetler: RAID ve NAS veri kurtarma
Son güncelleme: